Beantwortet von der Redaktion von Business.Digital Stand
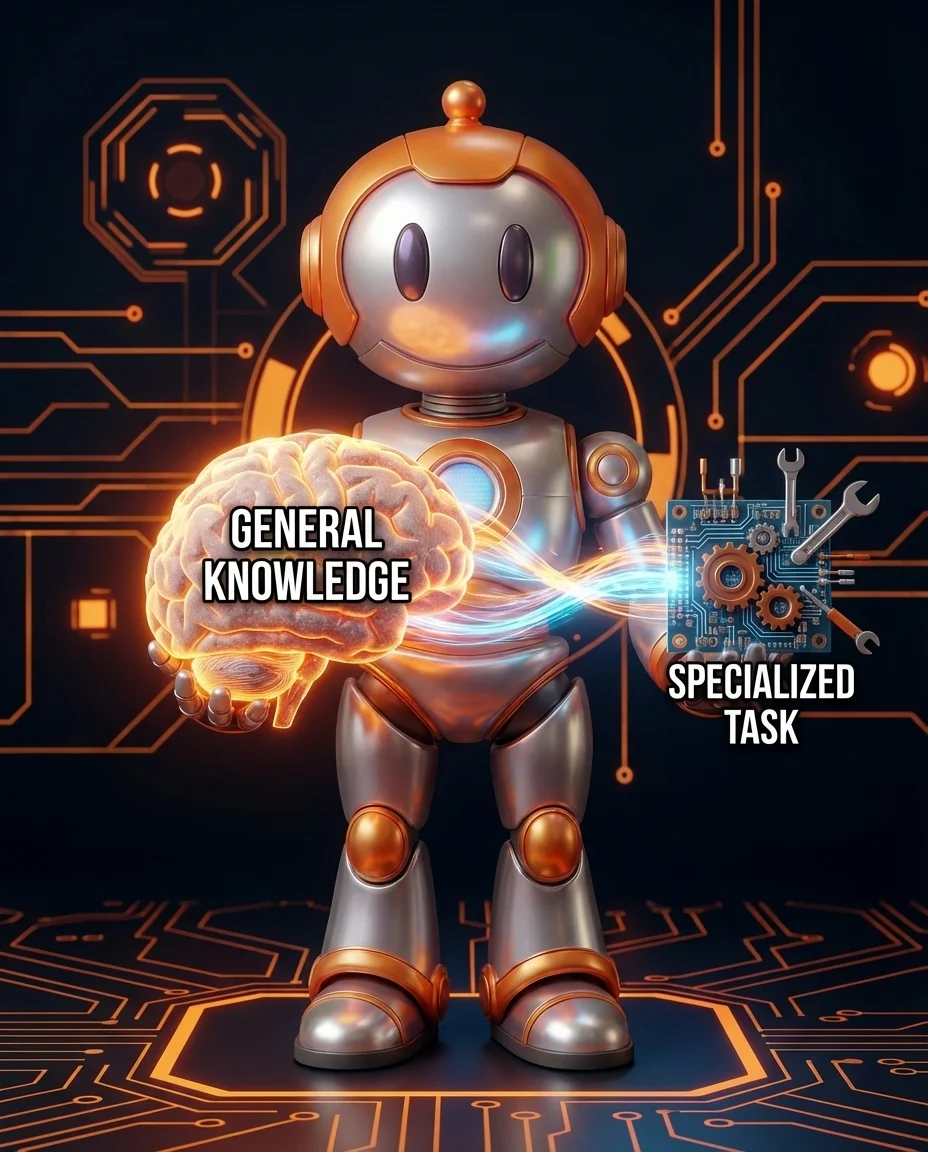
Transfer Learning bezeichnet den Ansatz, ein Modell, das für eine Aufgabe trainiert wurde, als Ausgangspunkt für eine andere, verwandte Aufgabe zu nutzen. Das Wissen, das das Modell in seinem ursprünglichen Training erworben hat, wird “übertragen” statt verworfen.
Die Analogie: Ein Mensch, der zehn Jahre Englisch spricht, lernt Niederländisch schneller als jemand, der noch keine Fremdsprache gelernt hat. Das Sprachgefühl, das Verständnis für Grammatikstrukturen, wird übertragen.
Wie funktioniert das technisch?
Ein Modell wird zunächst auf einem großen, allgemeinen Datensatz vortrainiert. Es entwickelt dabei allgemeine Merkmale: bei Bildmodellen Kanten, Formen, Texturen. Bei Sprachmodellen grammatikalische Strukturen, Semantik, Weltwissen. Dann wird das Modell mit einem kleineren, spezifischen Datensatz weitertrainiert (Fine-Tuning). Die frühen Schichten des Netzes, die allgemeine Merkmale gelernt haben, werden oft eingefroren oder nur leicht angepasst.
Warum ist das ein Paradigmenwechsel?
Vor Transfer Learning musste jedes Modell für jede Aufgabe von Grund auf trainiert werden. Das erforderte riesige Datensätze und erhebliche Rechenkapazität. Mit Transfer Learning und Foundation Models ändert sich das fundamental.
Ein großes Sprachmodell hat allgemeines Sprachverständnis durch Pre-Training entwickelt. Ein Unternehmen kann dieses Modell über Fine-Tuning mit einigen hundert eigenen Beispielen anpassen. Im Vergleich zu einem Training von Null sind das Größenordnungen weniger Rechenkosten, ein eigenes Modell von Grund auf ist für Mittelständler ohnehin keine realistische Option.
Für Unternehmen
Transfer Learning ist der Hauptgrund, warum KI heute für mittelständische Unternehmen zugänglich ist. Du profitierst von Milliarden-Dollar-Investitionen in Vortraining, ohne selbst investieren zu müssen. Was du einbringst: deine spezifischen Daten und Anforderungen. Wie man das konkret umsetzt, klären wir in einer KI-Beratung.